
Metadata bij meemoo
Een bestand dat niet of niet goed omschreven is, vind je moeilijk terug. De beschrijvende gegevens - oftewel metadata - die bij een bestand horen, zijn van groot belang wil je archiefmateriaal vindbaar en herbruikbaar maken. Voor onze dienstverlening naar partners en interne processen zijn metadata dus cruciaal. Bovendien willen we aan de hand van metadataverrijking en -uitwisselbaarheid de doorzoekbaarheid van het audiovisueel materiaal bewaard in het meemoo-archiefsysteem verbeteren.
De metadata die zich momenteel in ons archiefsysteem bevinden, zijn niet voldoende uniform. Met die uitdaging gaan we vandaag én in de toekomst aan de slag. Omdat metadata in zowat alle lagen van onze werking verweven zitten, is het belangrijk om dit complexe vraagstuk op een overkoepelende manier te benaderen. Binnen onze aanpak onderscheiden we vier lijnen - al is er ook een dosis overlap en zijn niet alle beslissingen in steen gebeiteld.
Een voorbeeld uit onze werking: bij een digitale-instroomtraject stromen niet alleen digitale bestanden ons archiefsysteem in, ook de beschrijvende gegevens die erbij horen, komen mee. Geen sinecure! Lees hier wat daar allemaal bij komt kijken.

1. Metadatabeheer
Onder het beheer van metadata verstaan we de processen en infrastructuurinvesteringen die wij zelf maken en die ons in staat stellen onze eigen noden en die van onze contentpartners beter in te vullen. Want de hoeveelheid data die instroomt in ons archiefsysteem neemt steeds meer toe: er sluiten meer contentpartners bij ons aan met nieuwe (types) collecties, en projecten rond o.a. artificiële intelligentie leveren nieuwe soorten metadata op. Dit alles heeft een weerslag op hoe onze metadatainfrastructuur er zou moeten uitzien en wat het zou moeten kunnen.
Daarom maakten we een plan op voor de komende jaren. In deze zogenaamde metadataroadmap trachten we de collectie aan huidige en toekomstige metadata om te bouwen tot een duurzaam en toegankelijk collectief geheugen. In 5 horizons verduurzamen, uniformiseren, en maken we metadata-opslag, de integratie van metadata met gebruikersapplicaties en de voorstelling van metadata robuuster.
Verdiep je in de acties die wij stellen:
De eerste mijlpaal binnen de metadataroadmap was het bouwen van een kennisgraaf, samen met Triply. Dit is een applicatie die kennis unificeert door zowel metadata, thesauri, gecontroleerde lijsten, als domeinmodellen samen en uniform toegankelijk te maken. Op termijn zullen de metadata die we op hetarchief.be ontsluiten, uit deze graaf komen.
In samenspraak met onze contentpartners ontwikkelen we een metadatamodel. Zo willen we collecties over contentpartners heen uniform doorzoekbaar maken. In kader van de roadmap sleutelen we verder aan dit model.
2. Ondersteuning van onze contentpartners en de brede sector
Onze contentpartners en bij uitbreiding de hele cultureelerfgoedsector hebben heel wat vraagtekens over de zorg voor metadata. Wij ondersteunen hen hierin door middel van opleidingen (zoals de bootcamp open culturele data), door allerhande goede praktijken te promoten, en eigen en externe tools (zoals Invulboeken) aan te reiken. Om de collecties van alle contentpartners uniform doorzoekbaar te maken, ontwikkelen we in samenspraak met hen een metadatamodel. Op developer.meemoo.be vinden ze naast deze modellen ook SIP-specificaties.
In de toekomst ondersteunen we onze partners graag verder met rapporten over de volledigheid van hun data, en met thesauri - want als je data niet kan linken aan een thesaurus met één gedefinieerd dataveld, blijven metadata vervuild. Daarnaast plannen we ook dieper in te gaan op de rapportering rond metadatakwaliteit.
Enkele voorbeelden van hoe wij onze contentpartners en de sector ondersteunen:
In kader van de metadataroadmap zorgen we voor uniforme modellen voor onze contentpartners. We beheren en documenteren deze, zodat ze voor iedereen beschikbaar en bruikbaar zijn.
Hoe maak je culturele data vindbaar, toegankelijk, uitwisselbaar en (her)bruikbaar? Dat bespreken we tijdens de bootcamp open culturele data. In diverse rechtenworkshops reiken we culturele organisaties handvaten aan om bewuster om te gaan met rechtenmetadata.
Wat-specificaties? Een SIP, of Submission Information Package, verpakt de mediabestanden en metadata van onze contentpartners op een gestandaardiseerde manier. Deze meemoo-SIP volgt internationale standaarden, en houdt rekening met de input van onze contentpartners. Zo kunnen wij aangeven op welke manier alle informatie verpakt moet worden, zodat alle objecten consequent aangeleverd worden én conform onze metadatamodellen zijn.
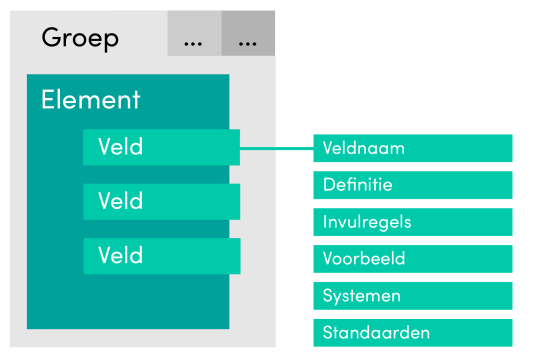
Met het Invulboek Objecten kunnen registratoren erfgoedobjecten eenvormig beschrijven. Dit maakt informatie over collecties vindbaar en bruikbaar. Via de beschrijvingsstandaarden in het Invulboek Publicaties documenteer je de belangrijkste eigenschappen van een publicatie.
3. Metadataverrijking
Hoe meer kwalitatieve metadata er zijn, hoe vlotter een bestand kan gevonden worden bij ontsluiting (bijvoorbeeld op hetarchief.be of de ontsluitingskanalen van onze partners). Daarom lopen er enkele trajecten waarin we de metadata bij bestanden in ons archiefsysteem aanvullen of verbeteren. Dit pakken we aan op twee manieren. Enerzijds gebruiken we de reeds bestaande metadata (van de contentpartner zelf, of uit digitaliseringsprojecten), anderzijds verkennen we semi-automatische metadatacreatie. Denk aan technieken uit de artificiële intelligentie (AI) zoals machine learning en computer vision.
We onderzoeken of we op die manier koppelingen kunnen maken met linked (open) data, en verdiepen ons in technieken als spraak-, entiteits- en gezichtsherkenning voor het verrijken van beschrijvende metadata. Daarnaast besteden we ook heel wat aandacht aan het creëren van juridische metadata, waardoor je weet wat je met je bestanden mag doen en onder welke voorwaarden.
Concrete projecten rond metadataverrijking:
In een project met de voormalige VKC (nu ook deel van meemoo) legden we een verbinding tussen het VKC-ecosysteem en het meemoo-ecosysteem, zodat beelden én metadata geautomatiseerd uitgewisseld kunnen worden.
In DO IT! begeleiden we 10 organisaties met het identificeren van collectiestukken als publiek domein met behulp van de Publiekdomeintool.
Op ons onderwijsplatform Het Archief voor Onderwijs kunnen lesgevers terecht om hun lessen te verrijken met kwalitatief audiovisueel materiaal van onze partners. Om hen vlot het juiste beeld- of geluidsfragment te helpen vinden, voorziet ons redactieteam ieder item zorgvuldig van beschrijvingen én leerobjectmetadata (onderwijsniveau, graad, vak en thema).
4. Uitwisselbaarheid
Wil je informatie eenvormig bewaren en bruikbaar maken, dan moeten de bijbehorende data op een uniforme manier opgebouwd zijn. Door datasets te structureren en beschikbaar te stellen als linked (open) data en deze waar mogelijk te linken aan externe authorities, maken we metadata uitwisselbaar. Hiervoor stemmen we af op standaarden, zoals de Vlaamse OSLO-standaard en internationale standaarden.
Projecten waardoor we metadata uitwisselbaar maken:
Enkele jaren geleden wees onderzoek naar een gemeenschappelijke thesaurus tussen meemoo en het Nederlandse Beeld en Geluid uit dat het linken van bestaande thesauri ervoor zorgt dat je op een uniforme manier doorheen verschillende collecties zoekt.
Met de Open Standaarden voor Linkende Organisaties (OSLO Cultureel Erfgoed) wil de Vlaamse overheid inzetten op een uniforme manier om metadata uit te wisselen. Als producteigenaar zetten we daar mee onze schouders onder: we organiseren de werkgroep OSLO Cultureel Erfgoed en stimuleren het gebruik van de standaard in de cultureelerfgoedsector. Bijvoorbeeld met het Invulboek Objecten of in proefprojecten.
Tweejaarlijks organiseren we een IIIF-Friday, waarmee we de sector informeren en aanmoedigen om IIIF (een standaard voor de uitwisseling van beelden) in te zetten.
In samenwerking met i-Learn stelden we thesauri samen voor het onderwijs. Zo kan er zowel op Het Archief voor Onderwijs als op het platform van i-Learn met dezelfde zoektermen en filters gewerkt worden. Verdiep je o.a. in onderwijsstructuur en vakken.